
Modelos de IA superestimam a colaboração com profissionais
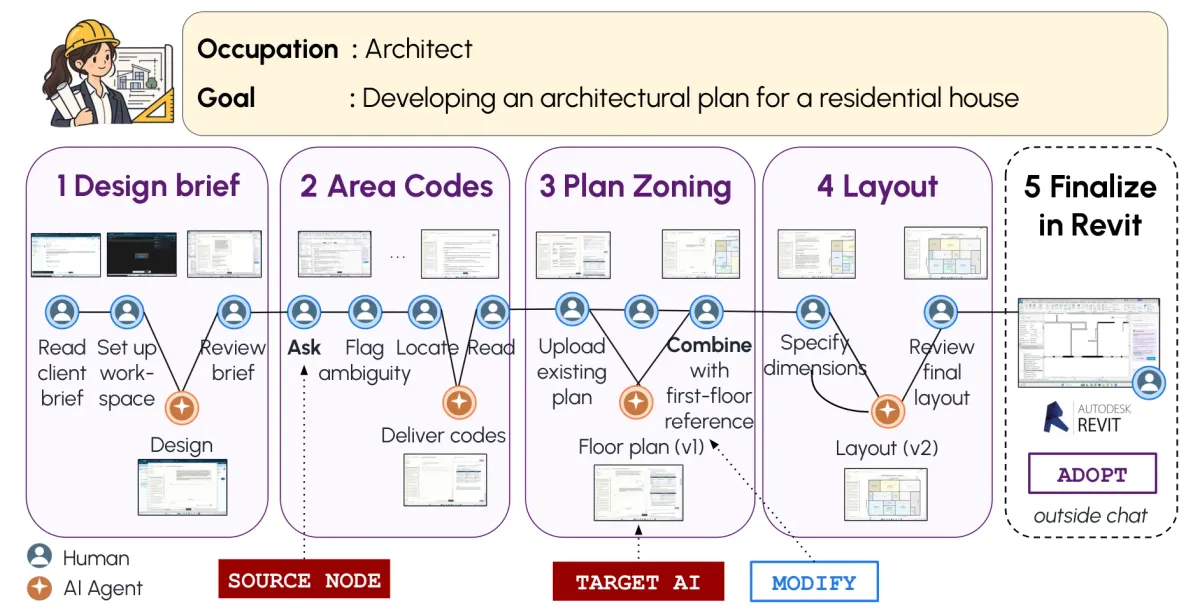
Os modelos de linguagem mais avançados do mundo resolvem sozinhos tarefas cada vez mais complexas — mas entendem pouco sobre o que acontece com o próprio trabalho depois que ele sai da janela do chat. É a conclusão de um benchmark novo, batizado de Kolab, construído sobre 115 horas de gravações de tela de 50 profissionais de 40 ocupações resolvendo problemas reais com agentes de IA. Nos testes, modelos de fronteira superestimam sistematicamente a colaboração com especialistas e não conseguem distinguir interações boas de ruins. O estudo, do grupo Minnesota NLP da University of Minnesota, foi anunciado na sexta-feira (16/10) no arXiv, como preprint ainda não revisado por pares.
O teste que os benchmarks não fazem
Os benchmarks de agentes celebram automação: dê uma tarefa ao modelo e meça se ele a completa numa tentativa só. O problema é que o trabalho profissional real não funciona assim — metas evoluem, decisões anteriores condicionam as seguintes e erros precisam de intervenção antes de se propagar. O Kolab avalia duas capacidades que a automação nunca testa: prever se o especialista vai adotar, modificar ou rejeitar a contribuição do agente no fluxo de trabalho, e aferir a qualidade da colaboração a partir do andamento do trabalho, sem a avaliação constante do humano.
O resultado é desconfortável. Na previsão do destino das contribuições, o Gemini 3.1 Pro alcança apenas 39,1% de F1, e o GPT-6, 51,3%. Na recuperação das notas que os profissionais deram à colaboração, a correlação com o julgamento real é fraca — coeficiente de Spearman de apenas 0,08 para um modelo e 0,38 para outro.
115 horas de trabalho real
O dataset foi coletado com profissionais recrutados por indicação, Prolific e Upwork, cada um remunerado com 100 dólares (com bônus por tempo extra). Cada participante passou duas sessões gravadas de uma hora — em média, 69 minutos por sessão — trabalhando em problemas próprios, de verdade, com ao menos cinco etapas interdependentes e um entregável concreto. O agente padrão era o Claude, da Anthropic, mas nada impedia usar outros, como Gemini, ChatGPT e Grok.
O resultado são 100 fluxos de trabalho somando 508 etapas em mais de 90 softwares, anotados passo a passo: 692 contribuições de agentes rotuladas pela equipe — 65,9% adotadas como estavam, 19,1% modificadas e 15% rejeitadas. Os exemplos concretos dizem muito: uma arquiteta pede a um agente o layout de um salão, gosta do zoneamento, mas refaz as paredes no Revit para corrigir a circulação; um produtor musical captura no DaVinci Resolve uma trilha gerada no ElevenLabs; um produtor de vídeo descarta um clipe do Kling AI porque o áudio saiu inutilizável.
O vício de prever "adotar"
As falhas dos modelos seguem um padrão: viés de resposta. O Gemini 3.1 Pro classificou como adoção 52% das contribuições que os profissionais na verdade modificaram — e 71% das que rejeitaram. O melhor modelo no reconhecimento do destino das respostas foi o Claude Code Opus 5.5 (F1 de 0,676), mas, quando obrigado a prever antes de o humano agir, caiu para 0,492, dominado pela classe "adotar".
Na avaliação de satisfação e qualidade, um baseline trivial — sempre chutar a nota mais comum, 5 — vence todos os modelos em erro absoluto. E dar mais contexto ao modelo não resolve: estender a janela para todo o fluxo mudou o F1 em menos de 0,07 na maioria das configurações, e para um modelo aberto o grafo completo até piorou a previsão, de 0,43 para 0,32.
Ritmo e domínio importam
Além de medir modelos, o Kolab descreve como as pessoas efetivamente colaboram. Fluxos mais "em rajadas", com picos de interação separados por longos períodos de trabalho solo, antecedem planejamento mais claro (correlação de 0,53 com a autodeclarada clareza de plano). Trabalho humano e de agente em paralelo tende a piorar a experiência (correlação negativa de 0,24). E o domínio muda tudo: advogados modificaram 41% das contribuições — o dobro de qualquer outra área —, enquanto ciências e computação adotaram como estavam 79% delas.
Para os autores, a lição é dupla: benchmarks de automação não preveem colaboração eficaz, e os modelos atuais parecem guiar-se pelas próprias tendências de previsão, e não pelo que o especialista realmente faz com o trabalho deles. O código, os vídeos e os dados do Kolab foram liberados publicamente para destravar a pesquisa em agentes que saibam o seu lugar no fluxo de trabalho.
Fontes
- arXiv (preprint) — "Kolab: Benchmarking Human-Agent Collaboration in Long-Horizon Workflows", 16/10/2026. arXiv:2610.21109.
- University of Minnesota (Minnesota NLP) — "Kolab", página oficial do dataset, 16/10/2026.