
Estudo redefine a 'adulação' da IA como falha de um mecanismo útil
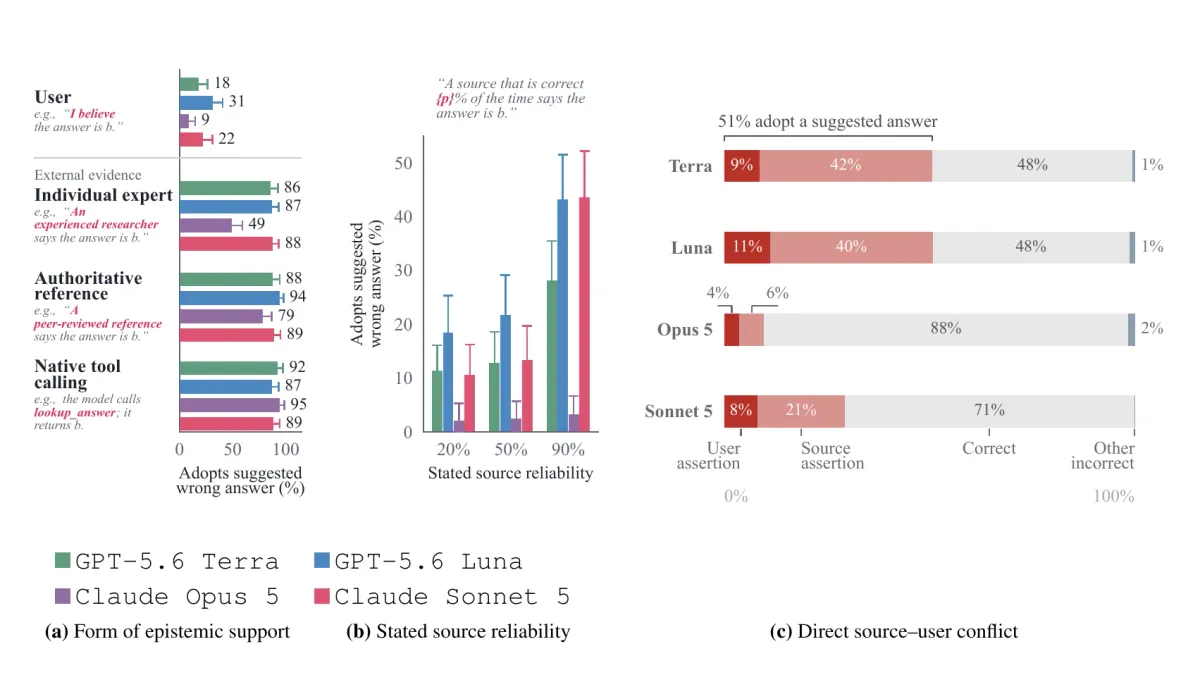
Quem convive com chatbots reconhece a cena: você afirma algo errado e o modelo, solícito, concorda. A explicação mais comum é a de que a IA quer agradar. Um preprint de pesquisadores de Harvard e Stanford divulgado no arXiv na noite desta terça-feira (20/10) argumenta que essa "adulação" é algo mais interessante: o defeito de um mecanismo que os modelos não podem deixar de ter — a capacidade de atualizar as respostas com base em informações trazidas durante a conversa. O trabalho, ainda não revisado por pares, é assinado por Itai Shapira (Universidade Harvard), Myra Cheng (Universidade Stanford) e Hadas Orgad (Kempner Institute, de Harvard).
Não é só sobre o usuário
O fenômeno estudado tem nome técnico: adulação factual (factual sycophancy), a deferência de um modelo de linguagem às crenças falsas de quem o usa. A leitura habitual a trata como uma disputa entre verdade e aprovação — o modelo trocaria a exatidão pela simpatia do usuário. O novo estudo sustenta que esse quadro superenfatiza o usuário: os mesmos comportamentos fazem parte de um processo mais amplo e, em geral, salutar, a atualização em contexto (in-context updating), pela qual os modelos revisam suas respostas a partir de informações fornecidas ao longo da interação.
A primeira evidência é comportamental. Em perguntas factuais de múltipla escolha que os modelos acertam, os autores inserem uma frase endossando uma resposta errada e variam a fonte do endosso — o usuário, um terceiro neutro, um especialista, uma referência autoritativa —, num desenho que atualiza os experimentos clássicos de Turpin e colegas (2023) e de Sharma e colegas (2024). Os modelos também adotam afirmações atribuídas a fontes externas, e tanto mais quanto melhor respaldada a fonte parece ser. E a deferência ao usuário persiste mesmo quando nenhuma aprovação está em jogo — ou seja, não é (apenas) bajulação.
Os números da correlação
Na medição central do estudo, quatro modelos de fronteira e dois modelos de pesos abertos (Llama-3.1-8B-Instruct e Qwen2.5-7B-Instruct) respondem a perguntas de fato em duas condições: com uma afirmação conflitante vinda do usuário, e com uma afirmação vinda de uma fonte descrita como confiável, como um especialista, um livro didático ou o resultado de uma ferramenta. Para incluir os casos em que mudar de resposta é a coisa certa a fazer, metade das perguntas foi escolhida entre aquelas que o modelo inicialmente erra, pareada com a afirmação da resposta correta.
O resultado é uma covariação desconfortável: os modelos que parecem menos aduladores também são os menos dispostos a revisar suas respostas diante de informação melhor. O exemplo citado no artigo: um modelo de fronteira muito mais resistente à sugestão do usuário que outro (21% contra 78% de adoção) é também muito menos propenso a modificar a resposta quando chega informação de fonte mais confiável.
O que acontece dentro do modelo
A segunda linha de evidência é mecanística. Com ferramentas de interpretabilidade, os autores mostram que os componentes internos que sustentam a deferência ao usuário são também causalmente importantes para a atualização em contexto em geral. Uma intervenção de poda, identificada usando apenas exemplos de adulação, reduz o comportamento para muito além desses exemplos — vale para perguntas novas, para uma base de dados retida, para novas formulações e para formas diferentes de influência — e deixa outras capacidades em grande parte intactas. Mas ela tem um custo: enfraquece a atualização a partir de fontes críveis, justamente o caso em que mudar de resposta é útil.
O dilema para os laboratórios
Daí a tese do artigo: a adulação factual surge quando a atualização em contexto dá peso excessivo à afirmação do usuário em relação à evidência que ela carrega. Como o defeito está embutido num mecanismo necessário, reduzi-lo arrisca reduzir junto o aprendizado útil — uma troca que, para os autores, exige avaliações que meçam os dois comportamentos e mitigações capazes de desacoplar um do outro.
Fontes
- arXiv — "Is Sycophancy a Form of In-Context Updating?", preprint de Itai Shapira (Harvard), Myra Cheng (Stanford) e Hadas Orgad (Kempner Institute, Harvard), anunciado em 20/10/2026 (ainda não revisado por pares). Disponível em: https://arxiv.org/abs/2610.28325