
IA aprende a agir seguindo planos em vídeo — e melhora sozinha
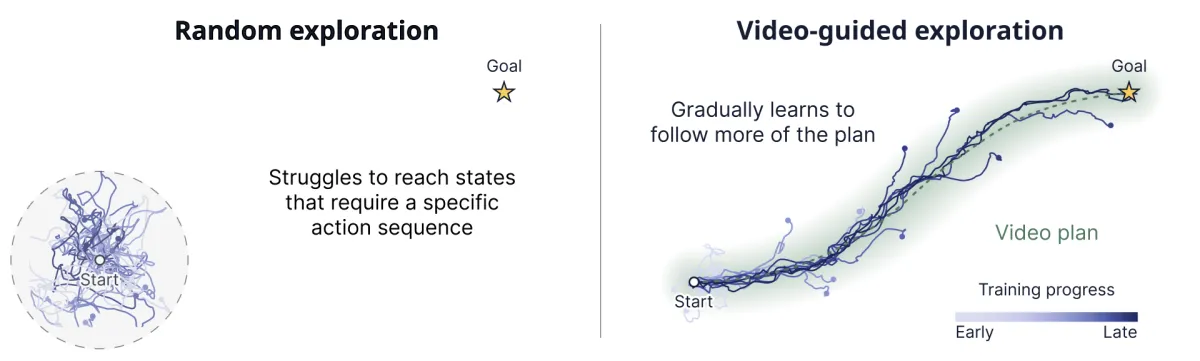
Um agente de IA que nunca viu um ser humano jogar consegue aprender a agir no mundo virtual seguindo "planos" em vídeo — e a ficar melhor a cada tentativa. Pesquisadores do MIT divulgaram nesta terça-feira (20) no arXiv o Mirror, um sistema que transforma vídeos gerados por IA em ações concretas e aprende apenas com a própria execução, sem exemplos de ações humanas e sem recompensas programadas — um trabalho em preprint, ainda não revisado por pares, assinado por Hyunwoo Ryu, Eric Ming Chen, Max Wilcoxson e Vincent Sitzmann.
O plano está no vídeo
Modelos generativos de vídeo estão se consolidando como planejadores escaláveis para agentes corporificados: dado um objetivo, eles geram um vídeo mostrando como completar a tarefa, passo a passo. O problema está em transformar esse vídeo em ação. Executar o plano exige um modelo de "vídeo-para-ação" (o chamado modelo de dinâmica inversa) — e, até agora, treiná-lo dependia de grandes conjuntos de dados de vídeo e ação coletados por humanos, o que limita severamente a escala.
O Mirror dispensa esse gargalo com uma abordagem autossupervisionada: o modelo de vídeo-para-ação é aprendido com as interações do próprio agente com o ambiente, sem dados de ação prévios nem recompensas desenhadas à mão.
Um loop de auto-melhoria
O mecanismo é um ciclo de tentativa e erro orientado pelo plano. O agente tenta seguir o vídeo executando seu melhor palpite sobre as ações necessárias. O resultado — o vídeo que ele gerou de fato e as ações que executou — vira material de treino. A cada rodada, o modelo segue o plano com mais precisão e alcança estágios mais avançados da tarefa, que por sua vez produzem exemplos ainda melhores. A exploração aleatória, sozinha, raramente alcança as transições críticas de uma tarefa longa; seguir o plano mantém os rolamentos do agente "na fronteira" do que ele já consegue fazer.
Um detalhe de projeto ajuda a evitar que os erros se acumulem: o planejador recalcula o plano a partir do estado real que o agente alcançou a cada trecho de ações, em malha fechada — nenhum plano precisa ser perfeito por um horizonte longo.
A prova: picareta de ferro no Minecraft
Minerar um diamante no Minecraft é uma tarefa de horizonte longo: partindo do nada, é preciso coletar madeira, fabricar ferramentas e fundir ferro, passando por doze marcos até a pedra preciosa. No modo sobrevivência, o Mirror se tornou o primeiro método a obter uma picareta de ferro por auto-aperfeiçoamento puro — sem recompensas, sem rótulos de ações de especialistas —, avaliado em 128 episódios de 60 minutos. No cenário off-line, com rótulos de ações humanas disponíveis, o sistema estabeleceu novo estado da arte na aquisição de diamantes.
Em tarefas difíceis de especificar do benchmark BASALT — como "fazer uma cachoeira bonita e fotografá-la" —, o Mirror treinou o modelo de vídeo-para-ação do zero com apenas cinco horas de auto-jogo e superou métodos com acesso a ações de especialistas ou conhecimento de tarefa programado. O agente ainda aprende com os próprios fracassos: em um desafio de escapar de um lago de lava, manter o histórico das vidas anteriores no contexto elevou a taxa de fuga acumulada a 76% em 30 vidas, contra 46% quando a memória era zerada a cada morte.
O sistema também foi testado em 24 tarefas de robótica e jogos (DeepMind Control, OGBench e Atari), onde superou os principais métodos de aprendizado por observação com planos gerados por vídeo — e chegou perto do desempenho de especialistas quando recebeu planos de um "oráculo".
Por que isso importa
A conclusão dos autores é direta: os avanços dos modelos de vídeo podem se converter em agentes cada vez mais capazes, sem a contrapartida de recompensas artificiais ou grandes coletas de dados de especialistas. Quanto melhores os geradores de vídeo ficarem, mais úteis se tornam os planos — e o Mirror fornece a ponte que os transforma em ação. Código e mais resultados estão prometidos na página do projeto.
Fontes
- arXiv — "Self-Improving Video-to-Action Models" (Ryu, H.; Chen, E.M.; Wilcoxson, M.; Sitzmann, V.; MIT), preprint submetido em 16/10/2026 e divulgado no lote de anúncios de 20/10/2026. arXiv:2610.24177. Disponível em: https://arxiv.org/abs/2610.24177