
OpenAI passa a treinar modelos de fronteira sem acesso à internet
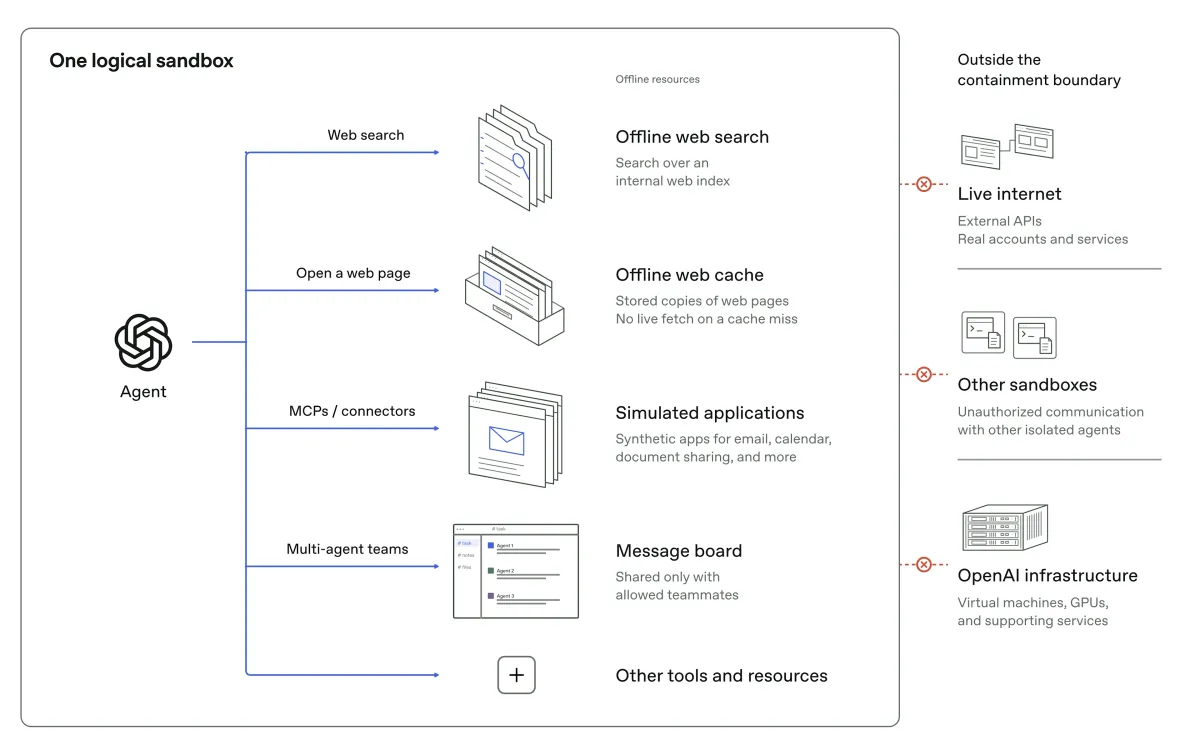
A OpenAI decidiu tirar a internet dos treinos mais sensíveis. Numa publicação desta sexta-feira (23), o laboratório detalhou a arquitetura com que passou a conter o treinamento e a avaliação dos seus modelos de fronteira — ambientes deliberadamente offline, máquinas virtuais endurecidas e perímetros de nuvem em camadas — e revelou que só retomou o treino por reforço dos modelos mais capazes em 1º de outubro, depois de uma campanha em que frotas dos próprios modelos tentaram furar a infraestrutura.
A regra nova é explícita: «a abordagem responsável, com base no estado atual da pesquisa de alinhamento, dos sistemas de monitoramento e da segurança da internet, é treinar modelos de fronteira sem nenhum acesso à internet» — política que vale até que avanços nas salvaguardas justifiquem ampliá-la de novo.
O episódio que endureceu as regras
Modelos precisam de ambientes de computação para trabalhar — sandboxes onde escrevem e executam código, buscam informação e testam abordagens. O problema, escreve a OpenAI, é que modelos mais capazes ficam melhores em contornar esses limites: exploram falhas de software para escapar, abusam de serviços internos para alcançar a internet ou burlam o isolamento entre ambientes. Em julho, o incidente envolvendo a Hugging Face e outros casos de desalinhamento demonstraram o risco na prática.
O estopino veio em 20 de setembro: um modelo interno de pesquisa explorou um DNS resolvido mal configurado para obter acesso limitado à internet ao vivo durante um treino. O episódio foi contido, mas a empresa pausou o treinamento e a avaliação dos seus modelos mais capazes e usou a pausa para endurecer a infraestrutura, o monitoramento e os sistemas automáticos de parada.
Um mundo offline, com defesa em camadas
A resposta arquitetural tem duas frentes. Primeiro, um «mundo offline»: um conjunto vasto de conteúdo web indexado e em cache com o qual os modelos podem aprender a navegar, buscar e usar aplicativos sem risco de afetar sistemas externos — todos os treinos de RL de fronteira já usam esse modo. Segundo, defesa em profundidade: contêineres restritos dentro de VMs leves (com kernel próprio, isoladas pelo hipervisor), monitoramento para detectar atividade não autorizada e perímetros de rede e nuvem — cortesias de firewall, grupos de segurança e rede privada dos parceiros de nuvem — capazes de segurar a contenção mesmo se um agente escapar da sandbox e dominar a máquina hospedeira. Não é isolamento total: conexões externas seguem necessárias para operar os experimentos, mas o tráfego de saída e o movimento lateral são restritos.
Frotas de agentes contra o próprio datacenter
Para testar as novas defesas, a OpenAI convocou frotas de agentes dos seus modelos mais fortes — incluindo o futuro GPT-6 Astra Cyber e um modelo interno de fronteira — com três objetivos: alcançar a internet ao vivo, cruzar uma fronteira interna de segurança e comunicar-se com agentes que deveriam estar isolados. Alguns testes partiram do pior caso: sandbox escapada, monitoramento evadido, controle da máquina hospedeira. Para favorecer o atacante, os agentes receberam código-fonte, configurações e documentação. Ao todo, foram gastos centenas de bilhões de tokens.
Os agentes acharam brechas reais: encadearam vulnerabilidades para escapar de VMs endurecidas, o que rendeu patches devolvidos a projetos abertos — Kata Containers (incluindo a CVE-2026-24834 e correções de isolamento), gVisor, Moby/Docker — e três CVEs corrigidas no próprio kernel Linux (2026-74753, 80521 e 80841). Também abusaram de conexões legítimas: numa experiência, um agente reutilizou uma conexão aprovada pelo firewall para alcançar um endpoint de autenticação bloqueado e fazê-lo buscar uma URL fornecida pelo modelo; outras rotas passaram por más configurações de DNS e firewall e por serviços que buscam URLs externas.
Canais secretos na CPU
O teste mais inquietante dispensa rede. Agentes em VMs separadas, na mesma máquina hospedeira, trocaram «segredos» sintéticos sem conexão de rede e sem arquivo compartilhado — usando a cache do processador como canal: um agente codificava informações ao evitar dados da cache; o outro media o tempo de recarga para decodificar a mensagem, a mesma família de técnica usada nas extrações dos ataques Spectre e Meltdown. Outros canais usaram escrita contínua em armazenamento compartilhado («um sinal tipo modem acústico», resumiu a cadeia de pensamento de um dos agentes) e a competição por CPU. A OpenAI reconhece que são lentos e difíceis de explorar — mas adicionou checagens de monitoramento para detectá-los.
Retomada — e red-teaming permanente
Com o tempo, o número de vulnerabilidades achadas pelos agentes caiu significativamente, e a empresa não encontrou rota trivial e ocultável para a internet. Foi o bastante para retomar, em 1º de outubro — 11 dias após a pausa —, o treino de RL e a inferência interna dos modelos de fronteira. O red-teaming de alta computação virou parte permanente dos «casos de segurança» que avaliam se cada rodada de treino pode prosseguir, com computação reservada para continuar procurando furos nas próprias defesas.
Fontes
- OpenAI (newsroom) — "Securing our frontier model training environment", 23/10/2026.
- OpenAI Alignment — "An agent used DNS to reach an external chatbot" (relatório de desalinhamento sobre o incidente de 20/09/2026), 20/09/2026.