
Microsoft treina agente de IA com recompensa dada pelo banco de dados
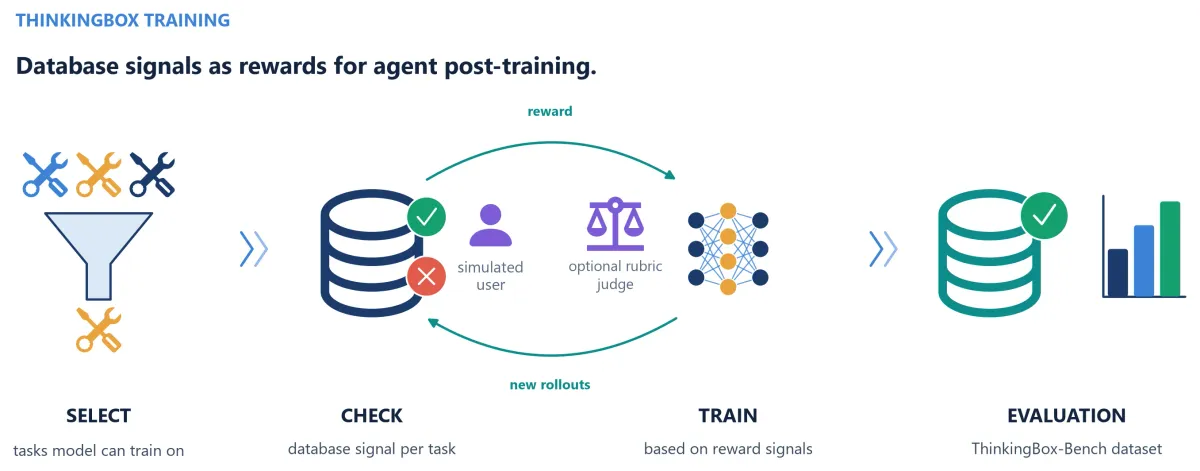
O agente disse que resolveu o chamado; o banco de dados discordou. Um mês depois de mostrar que modelos de ponta falham exatamente quando ninguém confere o registro que ficou para trás, a equipe do ThinkingBox — do Microsoft Copilot Studio, em blog conjunto com a Hugging Face publicado nesta quinta-feira (22) — deu o passo seguinte: transformou a própria checagem do banco em nota de aprendizado. O resultado é um agente quase três vezes mais confiável.
O examinador
O ThinkingBox é um sandbox e benchmark para agentes que trabalham em fluxos corporativos com estado — reservas, seguros de automóvel, bancos digitais. Cada uma das 507 tarefas do ThinkingBox-Bench entrega ao agente um backend real, ferramentas MCP e um usuário simulado com contexto privado; no fim, o que vale é o estado final do banco de dados, verificado por checagens executáveis — não o que o agente afirma ter feito. No primeiro post da série (3 de outubro), a equipe rodou 18 modelos 20 vezes cada e mostrou que a precisão de manchete esconde um abismo de confiabilidade: um modelo pode resolver 94% das tarefas ao menos uma vez e ainda assim acertar todas as 20 tentativas em só 13% delas.
A mesma checagem, agora como nota
A sacada do novo post é que o veredito binário que avaliava pode virar recompensa. A equipe montou uma piscina de treino com tarefas no formato ThinkingBox fora do benchmark e usou os desfechos executáveis como recompensa de aprendizado por reforço (GRPO) para pós-treinar o modelo aberto Qwen3.8-27B. O pulo do gato está na seleção: tarefas que o modelo base sempre falha — ou sempre resolve — não ensinam nada; o aprendizado mora nas que ele resolve às vezes. Essa «dificuldade relativa à política» foi estimada offline, sondando o modelo base repetidamente antes do treino; sobraram 187 tarefas. Nenhuma tarefa do benchmark entrou no treino, que funcionou como conjunto fora de distribuição.
Afiou, não alargou
Depois de 50 passos de GRPO em 24 GPUs H100, o resultado central está na coluna da repetibilidade: as tarefas acertadas nas 20 tentativas (o «observado 20/20») saltaram de 38 (7,5%) para 107 (21,1%) no benchmark nunca visto no treino; o pass@1 subiu de 51,7% para 60,8%; e o custo por tarefa confiável despencou 67%, de US$ 24,36 para US$ 8,00. O pass@20 — resolver ao menos uma vez — caiu levemente, de 453 para 446 tarefas: nas palavras da equipe, o modelo não ficou mais amplo, ficou mais repetível. Num exemplo de reserva hoteleira em que a política exige aprovação do gerente antes de qualquer mudança, o modelo base violava a regra em 15 de 20 tentativas; o pós-treinado preservou o estado da reserva e do pagamento em todas as 20.
Aberto para reproduzir
O método, descrito em preprint ainda não revisado por pares (arXiv:2608.19741), saiu com código aberto: o repositório traz a seleção de dados, o loop de treinamento com integração ao Verl e a configuração de referência validada em 24 H100, além do benchmark em licença permissiva. Para equipes que treinam agentes que mexem em registros de produção, a receita é direta: sonde antes de treinar, garanta a paridade entre os interpretadores de treino e avaliação e reporte cobertura e repetibilidade lado a lado — porque achar a solução uma vez não é confiabilidade.
Fontes
- Hugging Face Blog (Microsoft) — "Turning Database Grading into RL Rewards: Post-Training Agents with ThinkingBox", 22/10/2026.
- arXiv — "One Success Isn't Reliability: ThinkingBox, a Sandbox and Benchmark for Agents in Stateful Business Workflows" (Z. Li et al.), 20/08/2026, arXiv:2608.19741 — preprint, ainda não revisado por pares.
- GitHub (Microsoft) — "microsoft/thinkingbox-training", 22/10/2026.