
gKSM: a deduplicação de memória do Linux chega às GPUs de IA
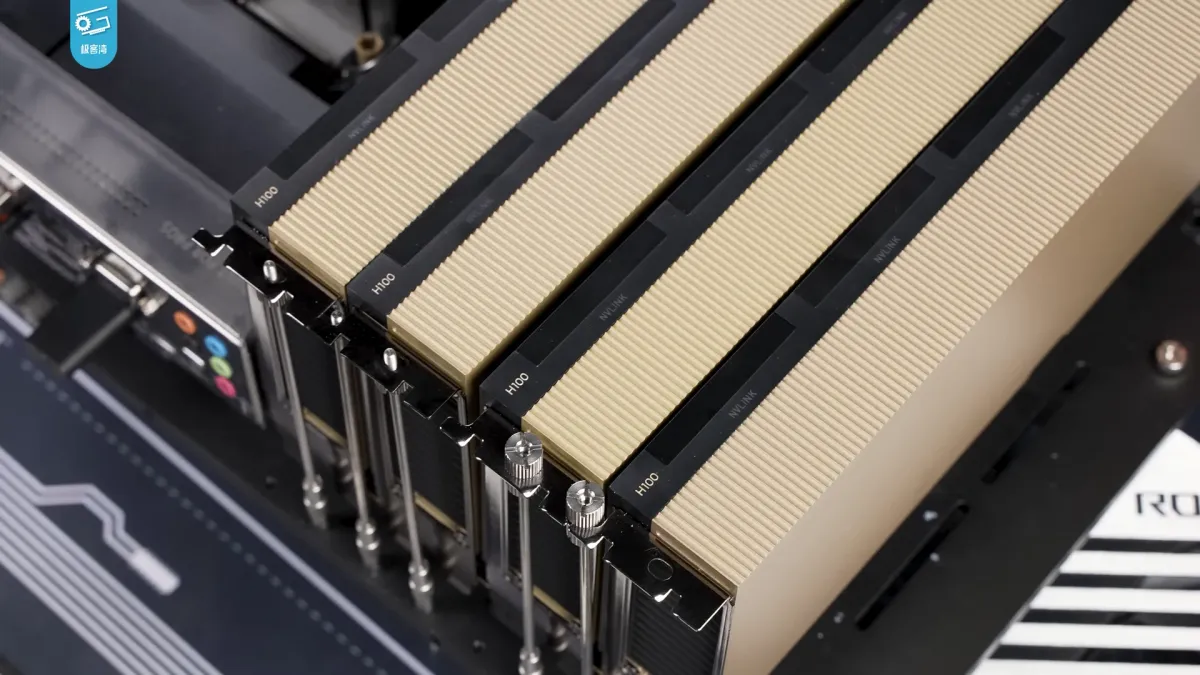
Quando vários serviços de IA dividem a mesma GPU, cada um carrega sua própria cópia dos pesos do modelo — uma duplicação que virou o principal gargalo de memória na inferência serverless de grandes modelos de linguagem. Pesquisadores da Universidade de Ciência e Tecnologia da China (USTC) e da Universidade Chinesa de Hong Kong (CUHK) divulgaram nesta terça-feira (20) no arXiv o gKSM, um framework que aplica à memória de vídeo a deduplicação de páginas — técnica consagrada no kernel Linux — direto na camada de driver. O trabalho foi aceito na conferência USENIX ATC 2026 e, nos experimentos, cortou em 59,8% o uso de memória de GPU mantendo a taxa de transferência.
O problema: cópias demais na GPU
Provedores de nuvem co-localizam múltiplas instâncias de inferência em uma mesma GPU para melhorar a utilização. O problema é que cada instância mantém, de forma independente, os pesos do modelo e o estado de execução. Como muitos desses serviços rodam o mesmo modelo de base, a memória de vídeo acaba repleta de páginas idênticas — cópias e cópias dos mesmos pesos.
Do KSM do Linux para o driver
Eliminar dados duplicados é uma técnica padrão em sistemas de CPU: o kernel Linux dedica a isso o KSM (Kernel Same-page Merging), que desde 2009 funde páginas de memória idênticas — ganho clássico em virtualização. Levar a mesma ideia para a memória de GPU, porém, esbarra em dois desafios fundamentais: é preciso evitar a movimentação redundante de dados entre CPU e GPU (a travessia do barrimento é cara) e preservar o isolamento de escrita das páginas compartilhadas — sem o suporte nativo a copy-on-write que a CPU tem.
É dessa travessia que o gKSM tira o nome e a solução. O framework opera de forma transparente na camada de driver com três engrenagens principais: a gestão de hash colaborativa entre CPU e GPU, que descarga o cálculo dos hashes para kernels na própria GPU; a deduplicação de pesos do modelo em "cópia zero", que elimina a duplicação antes mesmo da transferência dos pesos para a placa; e um tratador de faltas de página que atravessa fronteiras de privilégio, combinando um hook leve de kernel com remapeamento da Virtual Memory Management (VMM) da CUDA no espaço de usuário — assim uma instância só ganha sua cópia privada no momento em que precisa escrever.
Completam o pacote um algoritmo de varredura estável de páginas (para achar duplicatas sem sobrecarregar o sistema) e uma política de colocação consciente de reuso, que decide onde alocar novas instâncias em escala de cluster para aproveitar o que já está na memória.
Os números
Comparado ao ServerlessLLM, o gKSM reduziu o uso de memória de GPU em 59,8% mantendo throughput elevado. Em cenários com memória restrita, melhorou o throughput agregado em 2,15 vezes e sustentou cinco instâncias rodando simultaneamente na mesma GPU. Em simulação de nível de cluster, o sistema alcançou taxa de serviço de 99,97% — contra 78,2% do SLInfer e 26,9% do ServerlessLLM.
Um problema de sistemas operacionais clássico, revisitado pela IA
O artigo é mais um capítulo do encontro entre duas agendas: a infraestrutura clássica de sistemas operacionais — gerência de memória, faltas de página, políticas de colocação — e a demanda desproporcional dos serviços de inferência de LLMs. O preprint (submetido em 18/10 e anunciado hoje no arXiv) traz a versão de trabalho aberto, com licença CC BY 4.0, do artigo aceito na USENIX ATC 2026, publicado também nos anais da ACM.
Fontes
- arXiv — "gKSM: GPU Memory Deduplication at Driver Layer for Serverless LLM Inference" (Gao, S.; Guo, F.; Li, Y.; Yue, Z.; Xu, Y.; Lui, J.C.S.; USTC/CUHK), aceito na USENIX ATC 2026 e divulgado no lote de anúncios de 20/10/2026. arXiv:2610.25219; DOI: 10.1145/3828523.3857017. Disponível em: https://arxiv.org/abs/2610.25219